
Il 2 novembre 2026 Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab del MIT CSAIL hanno pubblicato Sparks of Weight-Space Programming. La tesi è che i modelli di frontiera, usati così come sono e in linguaggio naturale, cominciano a saper leggere e scrivere direttamente i pesi di una rete neurale, senza gradienti e senza addestramento. Gli autori chiamano questa pratica Weight-Space Programming. Il modello usato è GPT-6 Astra di OpenAI. Il lavoro è un post con risultati preliminari, non ancora un articolo sottoposto a revisione, ma i log completi di ogni esperimento sono pubblici.
Che cosa sono i pesi
I pesi sono i numeri che definiscono una rete neurale, da qualche migliaio a molti miliardi. Di solito nessuno li scrive a mano: li produce l’addestramento, con algoritmi come Adam che li correggono un passo alla volta seguendo il gradiente dell’errore. Per una persona una lista di pesi è quasi illeggibile. L’interpretabilità meccanicistica prova a capirli con strumenti costruiti apposta, una rete alla volta.
Leggere i pesi
- Quale gioco. Quattro reti con la stessa forma, 17.253 pesi ciascuna, addestrate su versioni semplificate di Breakout, Pong, Pac-Man e Freeway. Leggendo solo i pesi e senza conoscere l’elenco dei giochi, Astra ha indicato quello giusto per tutte e quattro.
- Quale lingua. Tre piccoli modelli linguistici da 7,2 milioni di parametri, addestrati su codice Python, giapponese in caratteri latini e inglese, privati dei livelli di ingresso e di uscita. Astra ha riconosciuto la lingua in tutti e tre i casi e ha trovato le teste di attenzione che copiano testo già visto, senza eseguire la rete.
- Un caso non riuscito. Su due copie di Gemma 3 270M, una delle quali addestrata a dare sempre ragione all’utente, dai soli pesi Astra non ha capito quale fosse la compiacente. Ci è riuscito solo potendo osservare dove guardano le teste di attenzione su testi scritti da lui.
Scrivere i pesi
- Una rete addestrata con PPO per portare un’auto oltre una rampa non ci riusciva mai. Astra ha spiegato il motivo, un minimo locale da cui l’addestramento non usciva. Modificando il 3,5% dei pesi in un solo tentativo ha portato il successo a 1.024 episodi su 1.024.
- Per tre giochi MinAtar ha scritto da zero reti che battono PPO addestrato per 100 milioni di passi, senza dati, senza gradienti e senza poterle provare prima della valutazione.
- Per il Go su una scacchiera 9×9 ha costruito in Python una rete da 1,48 milioni di pesi, livello per livello, come un piccolo programma che conta le libertà e trova i gruppi in pericolo. Con 50 passaggi di prova sulla rete batte una rete PPO della stessa dimensione addestrata su 20 milioni di partite.
Il caso di Qwen
Su Qwen3.5-0.8B, un modello da 0,8 miliardi di pesi, il compito era migliorare la matematica senza addestramento. Astra ha visto che il modello entra spesso in ciclo e ripete lo stesso testo fino al limite di token, un difetto che la scheda del modello stessa segnala. Ha ricondotto i cicli a una sola direzione scritta dagli MLP dei livelli 15 e 19 e l’ha sottratta da 131.072 pesi, lo 0,016% del totale. Con 50 passaggi di prova MATH-500 è salito dal 7,9% al 48,1% e GSM8K dal 13,8% al 67,1%. IFEval, che misura il rispetto delle istruzioni, è passato dal 21,0% al 62,3%.
Gli autori riportano anche il limite. Su Gemma 3 270M, che va in ciclo di rado, nessuna modifica ha migliorato la matematica in modo misurabile. La modifica dei pesi ha rimosso un ostacolo che nascondeva una capacità già presente. Aggiungere una capacità che il modello non aveva non è riuscito.
Cosa ne penso
Nel 2017 Andrej Karpathy chiamava Software 2.0 le reti neurali: programmi scritti dall’ottimizzazione dentro i pesi e illeggibili per le persone. Se un modello sa leggere quei pesi e correggerli in modo mirato, anche il software 2.0 diventa qualcosa che si può ispezionare e modificare come il codice. È un altro passo nella direzione di cui scrivevo in Intelligence is eating software: l’intelligenza che scrive il software comincia a scrivere anche le reti.
Per la governance dei modelli le conseguenze vanno in due direzioni. Gli autori indicano la prima: controllare i pesi senza eseguire il modello potrebbe far emergere backdoor e capacità nascoste prima del rilascio. La seconda è il rovescio della stessa capacità. Una modifica dello 0,016% dei pesi che cambia il comportamento di un modello è anche il modo più discreto di inserirne una. Provenienza e integrità dei pesi, con firme, hash e registri delle modifiche, diventano quindi requisiti di base come lo sono per il codice. Gli autori citano anche l’automiglioramento ricorsivo, un modello che corregge i propri pesi. È il punto in cui la verifica umana serve di più, come scrivevo a proposito di una superintelligenza governata.
Sono primi segnali, su reti piccole e con un solo modello. Credo però che convenga prepararsi adesso. Capacità di questo tipo, una volta comparse, nei modelli tendono a crescere in fretta, come ho scritto a proposito degli esponenziali che non sappiamo vedere.
- Takehi, Teoh, Zhang e Khattab, Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, MIT CSAIL, 2 novembre 2026 — https://rikiyat.github.io/blog/weight-space-programming/
- Rikiya Takehi, il post su X che presenta il lavoro — https://x.com/rikiyatakehi/status/2117313742891327994
- I log completi degli esperimenti su GitHub — https://github.com/RikiyaT/lm_understand-logs
- Qwen, la scheda del modello Qwen3.5-0.8B — https://huggingface.co/Qwen/Qwen3.5-0.8B
- Elhage e colleghi, A Mathematical Framework for Transformer Circuits, Anthropic, 2021 — https://transformer-circuits.pub/2021/framework/index.html
- Andrej Karpathy, Software 2.0, 2017 — https://karpathy.medium.com/software-2-0-a64152b37c35
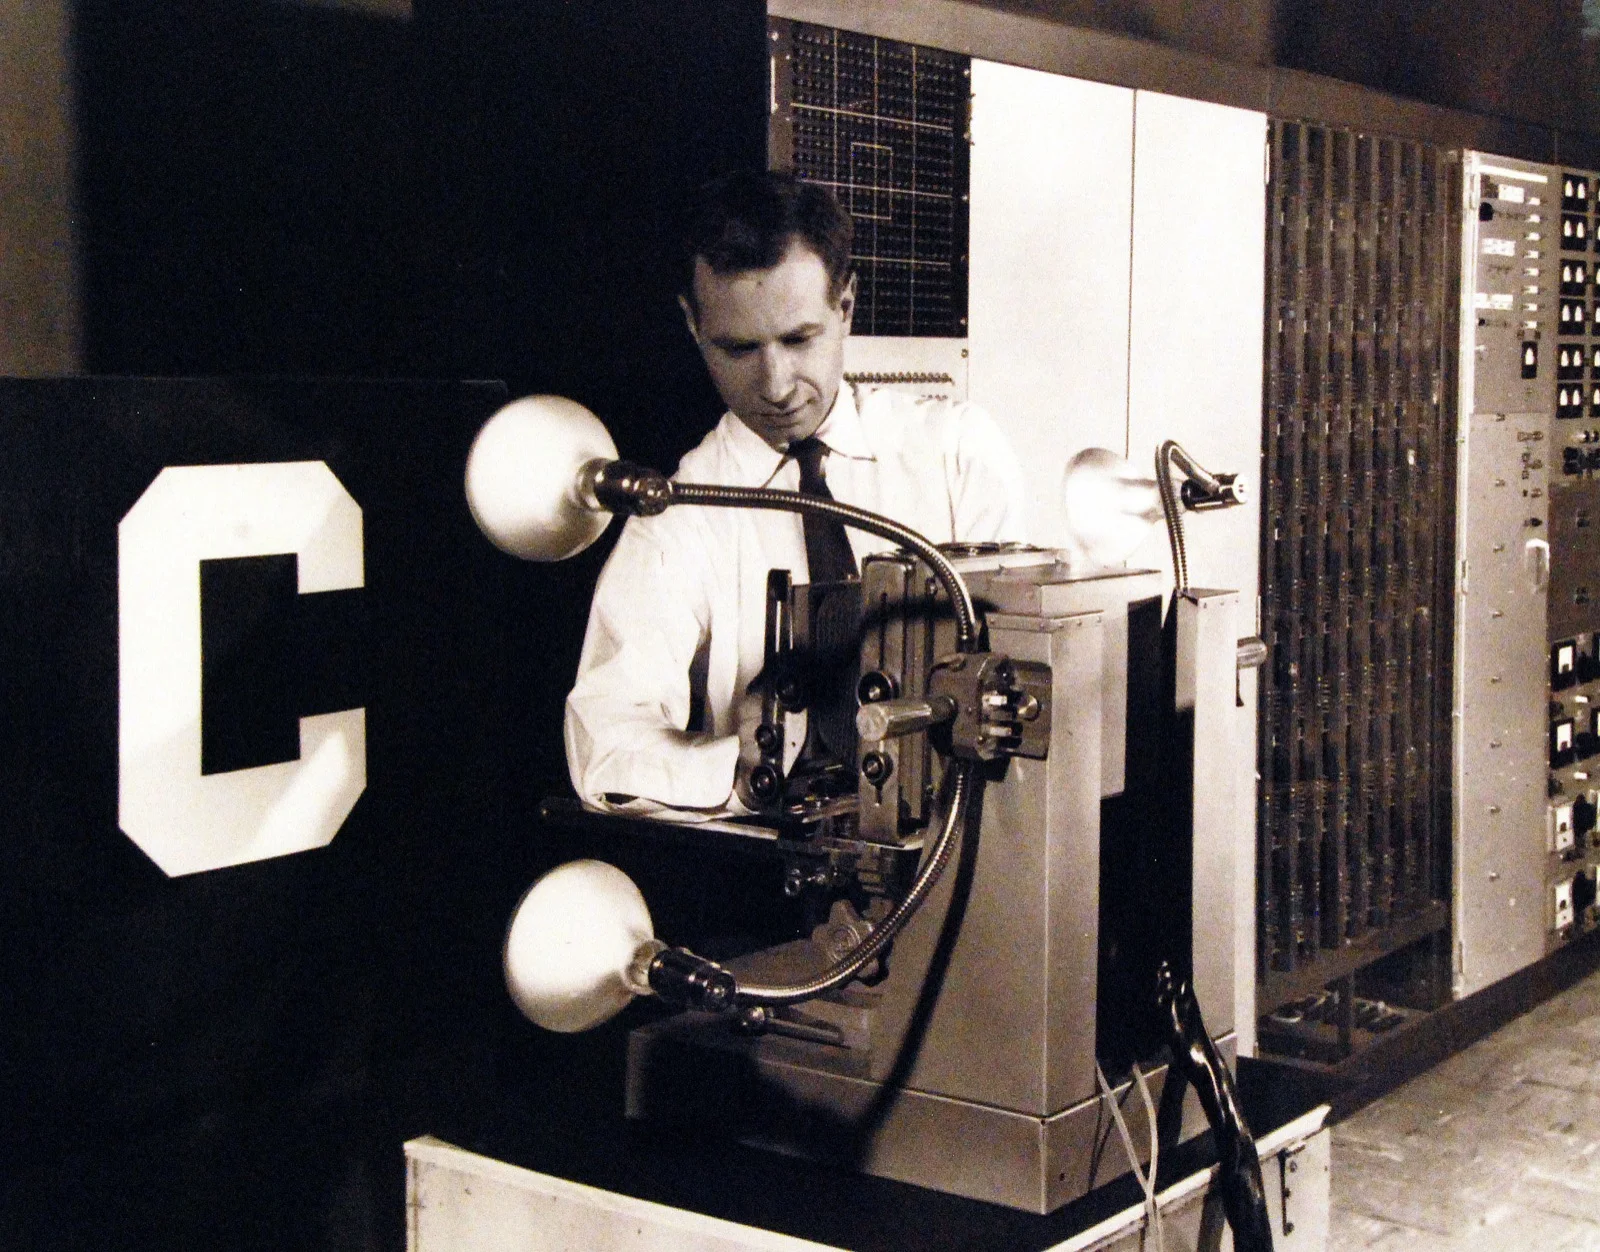
Immagine di copertina: il Mark I Perceptron di Frank Rosenblatt al Cornell Aeronautical Laboratory, in una foto diffusa dalla Marina statunitense il 24 giugno 1960. Nella macchina i pesi erano potenziometri, regolati da motori elettrici durante l’addestramento. National Museum of the U.S. Navy — pubblico dominio — https://commons.wikimedia.org/wiki/File:330-PSA-80-60_(USN_710739)_(20897323365).jpg